
У хмарно-нативній архітектурі, коли мікросервіс виходить з ладу, спрацьовують запобіжники (circuit breakers), трафік перенаправляється, а Kubernetes за лічені секунди запускає резервні копії. Система відновлюється, перш ніж кінцеві користувачі помітять збій.
Проте в межах корпоративних конвеєрів даних режими відмовостійкості залишаються напрочуд крихкими. Незначна, неоголошена зміна API вищого рівня перетворює цілочисельне поле на текстове; сторонній постачальник оновлює схему опівночі; або ETL-завдання завершується успішно, але мовчки втрачає 15% своїх даних. Внаслідок цього на панелях приладів керівництва відображаються неточні показники доходу, порушується нормативна звітність, а системи прийняття фінансових рішень діють на основі спотворених вхідних даних.
Протягом останніх кількох років галузь об’єдналася навколо концепції “самовідновлюваних конвеєрів даних” як Святого Грааля надійності даних. Але з розширенням корпоративних даних у мультихмарних середовищах — і з розгортанням автономних ШІ-агентів, які приймають операційні рішення в режимі реального часу — простого самовідновлення вже недостатньо.
Для підтримки наступного покоління корпоративного ШІ необхідно перейти від реактивного автоматизованого відновлення до Автономного Управління Даними та Стійкої Інфраструктури.
Невидиме вузьке місце у великомасштабних трансформаціях
Маючи досвід багаторічних корпоративних трансформацій даних у великих банківських установах, медичних мережах та загальнонаціональних дистрибуційних екосистемах, включно зі складними середовищами в USAA, Health Care Service Corporation (HCSC), Blue Cross Blue Shield Kansas (BCBS KC) та United Natural Foods (UNFI), я спостерігав поширену структурну проблему: швидкість обробки даних випереджає традиційні методи управління.
Під час міграції застарілих локальних сховищ даних на сучасні хмарні платформи (як-от Snowflake, dbt та хмарно-нативні озера) команди часто відтворюють застарілі припущення. Вони будують швидші конвеєри, але не роблять їх розумнішими.
У великомасштабних операціях — таких як управління кредитними лімітами для мільйонів банківських клієнтів або оптимізація запасів у ланцюгах постачання по сотнях дистрибуційних центрів — збої даних рідко проявляються як чіткі, критичні зупинки. Натомість вони призводять до тихої деградації:
-
Дрейф схеми: Вихідні системи вищого рівня розвиваються без повідомлення про критичні зміни аналітичним системам.
-
Семантичне спотворення: Дані надходять вчасно і у правильному форматі, але бізнес-логіка, що застосовується до них, відхилилася від поточних операцій.
-
Непрозорість походження даних: Команди знають, де стався збій у конвеєрі, але не можуть відстежити, які похідні моделі, звіти чи нормативні документи були скомпрометовані помилкою.
Три стовпи автономної стійкості даних
Щоб вирішити цю проблему, сучасні лідери з інженерії даних повинні змінити свою архітектурну філософію. Надійність не можна додати на рівні звітності; вона повинна бути вбудована безпосередньо в механізм виконання.
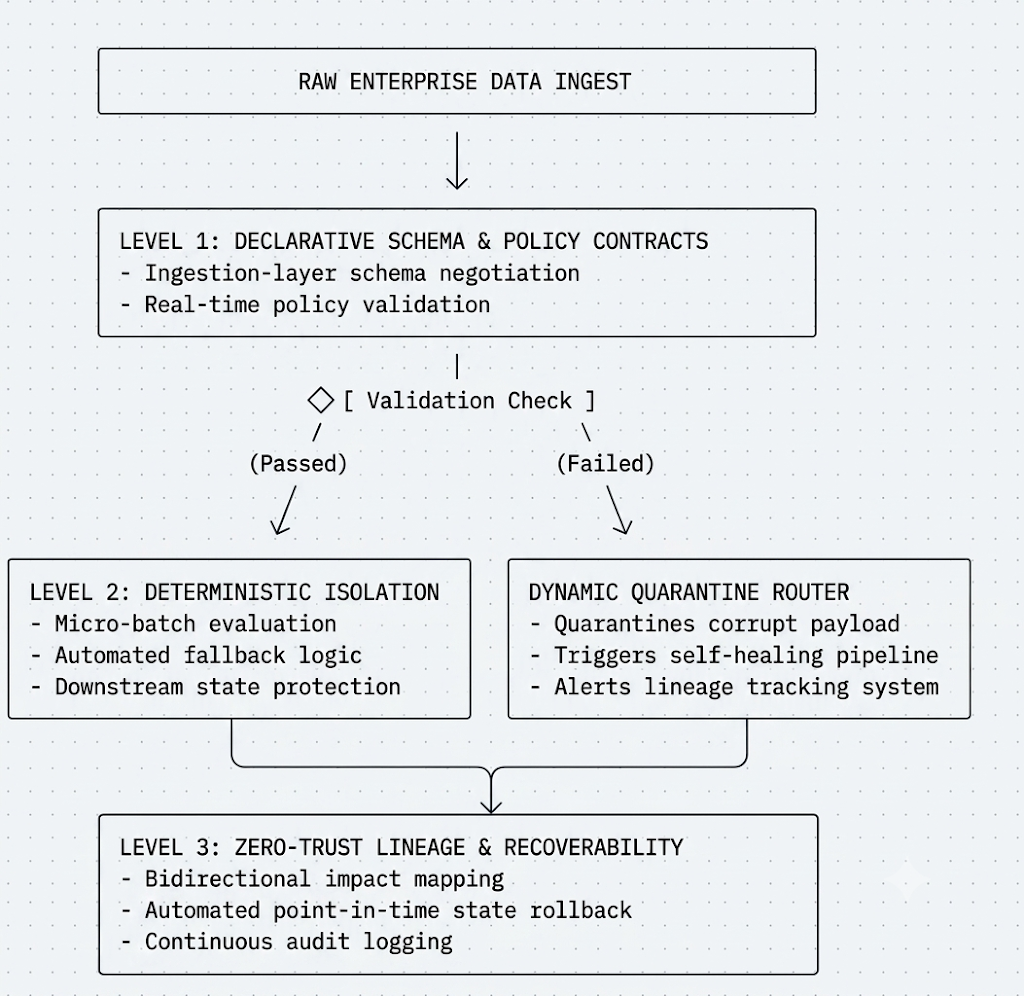
1. Декларативні контракти даних з динамічним узгодженням
Традиційні ETL покладаються на жорстко закодовані припущення. Якщо поле змінюється, завдання аварійно завершується. Стійка архітектура використовує декларативні контракти даних, що застосовуються в момент введення.
Коли вихідні системи намагаються надсилати дані, що порушують очікувані схеми або бізнес-правила, платформа не просто аварійно завершує роботу або мовчки приймає некоректні записи. Вона динамічно узгоджує пакет даних — ізолюючи аномальні записи в окремих проміжних зонах, дозволяючи при цьому валідним пакетам безперебійно надходити далі.
2. Детерміноване виправлення замість евристичних припущень
Хоча виявлення аномалій на основі ШІ корисне для сповіщень, автоматичне виправлення в критично важливих середовищах повинно залишатися детермінованим. Якщо автоматизований скрипт намагається “вгадати”, як виправити відсутній первинний ключ у фінансових або медичних записах, він ризикує внести синтетичні помилки в системи, що підлягають аудиту.
Автономне управління поєднує виявлення аномалій на основі машинного навчання з попередньо визначеними робочими процесами виправлення, керованими політиками. Якщо конвеєр стикається з несподіваним відхиленням, система ізолює пакет, застосовує історичну резервну логіку та сповіщає інженерні команди з попередньо обчисленою діагностикою першопричини.
3. Нульова довіра до походження даних
У сучасних корпоративних архітектурах відстеження походження даних має працювати за моделлю нульової довіри. Кожен етап трансформації даних повинен явно перевіряти походження, оцінку якості та класифікацію безпеки набору даних перед передачею його на наступний етап.
Якщо оцінка якості набору даних падає нижче встановленого порогу, похідні залежності (такі як моделі рекомендацій для клієнтів або панелі відповідності нормам) автоматично призупиняють оновлення або переходять на кешовані, перевірені вектори стану, доки аномалія не буде усунена.
Стратегія лідерства: Масштабування технологій шляхом масштабування стандартів
Архітектурні моделі ефективні настільки, наскільки ефективна інженерна культура, яка їх реалізує. Як член журі великих світових технологічних нагород, таких як TITAN Innovation Awards та TITAN Business Awards, і оцінивши понад 20 глобальних технологічних конкурсів, я часто оцінюю корпоративні системи, які стверджують, що використовують передові ШІ та архітектури даних.
Відмінність між організаціями, які досягають справжньої операційної гнучкості, і тими, хто загруз у технічному боргу, завжди полягає в стандартах та ретельності:
-
Ставтеся до конвеєрів як до розподілених програмних продуктів: Застосовуйте суворі принципи програмної інженерії до даних, включаючи модульність, автоматизоване тестування, безперервну інтеграцію (CI/CD) та інфраструктуру, керовану версіями (Infrastructure as Code).
-
Відокремлюйте управління від виконання: Надайте командам інженерії даних можливість створювати самообслуговувані фреймворки управління, які дозволяють командам доменів безпечно розгортати конвеєри, не створюючи централізованих вузьких місць.
-
Вимірюйте те, що має значення: Відійдіть від показників марнославства, таких як загальний обсяг збережених даних або створені конвеєри. Відстежуйте середній час до виявлення (MTTD), середній час до відновлення (MTTR) для порушень конвеєрів та індекс якості даних (DQI) для критично важливих корпоративних активів.
Шлях вперед
Оскільки підприємства переходять від пасивної аналітики до активних операційних робочих процесів на основі ШІ, надійність даних стає не просто показником ІТ-обслуговування, а основним бізнес-ризиком.
Створюючи системи, які не просто повідомляють про збої, а активно захищають, ізолюють та усувають проблеми якості даних у режимі реального часу, лідери з даних підприємств можуть забезпечити непохитну основу, необхідну для ери ШІ.
Шашанк Акінапаллі — Технічний архітектор / Старший інженер даних та старший член IEEE
Джерело новини: venturebeat.com