
MLPerf v6.1 вже доступний, з результатами від AMD, NVIDIA та Intel у низці AI-бенчмарків.
AMD та NVIDIA демонструють високу продуктивність в MLPerf 6.1, Intel також представила Xeon та Arc Pro
Останнє оновлення від MLCommons — це набір бенчмарків MLPerf Inference v6.1, який містить низку робочих навантажень, що відповідають останнім тенденціям у сегменті ШІ. Традиційно, усі три компанії подали результати своїх актуальних апаратних рішень, які ми зібрали в наведені нижче таблиці.
2 з 9
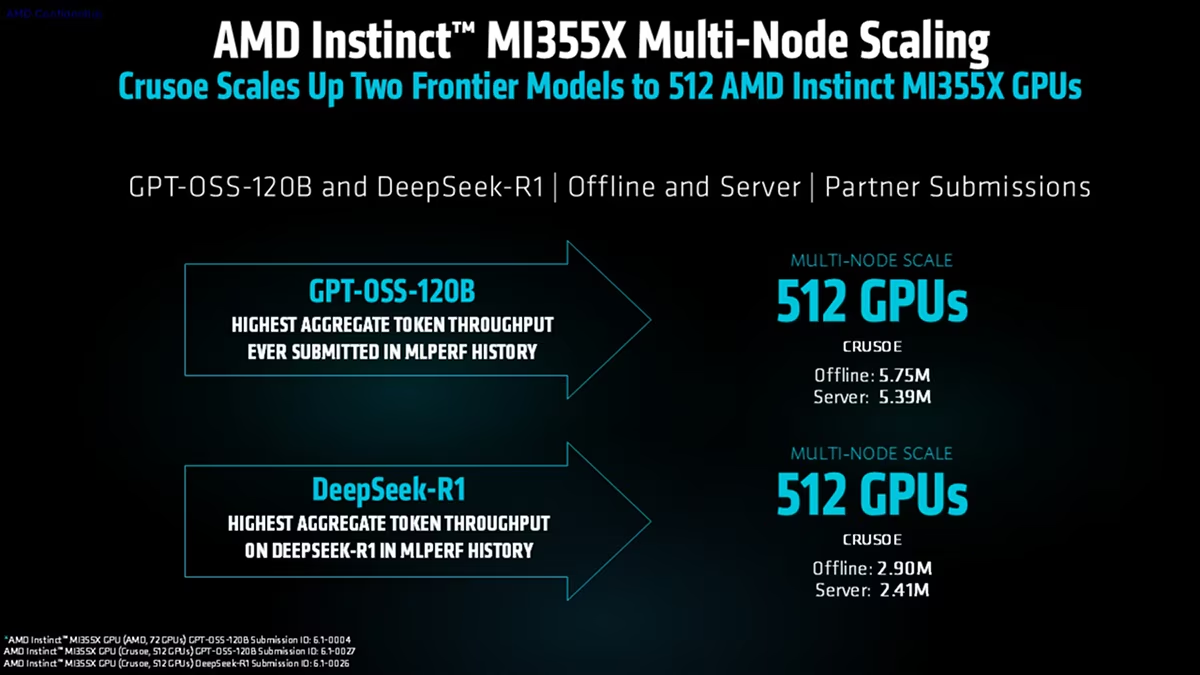
Починаючи з DeepSeek R1, AMD демонструє конфігурацію кластера з 512 GPU Instinct MI355X. Це забезпечує лідерство у продуктивності як для офлайн, так і для серверних сценаріїв використання. Рішення NVIDIA GB300 та GB200 тестувалися у конфігураціях з 288 GPU, причому конфігурація GB300 була близькою до платформи MI355X.
2 з 9
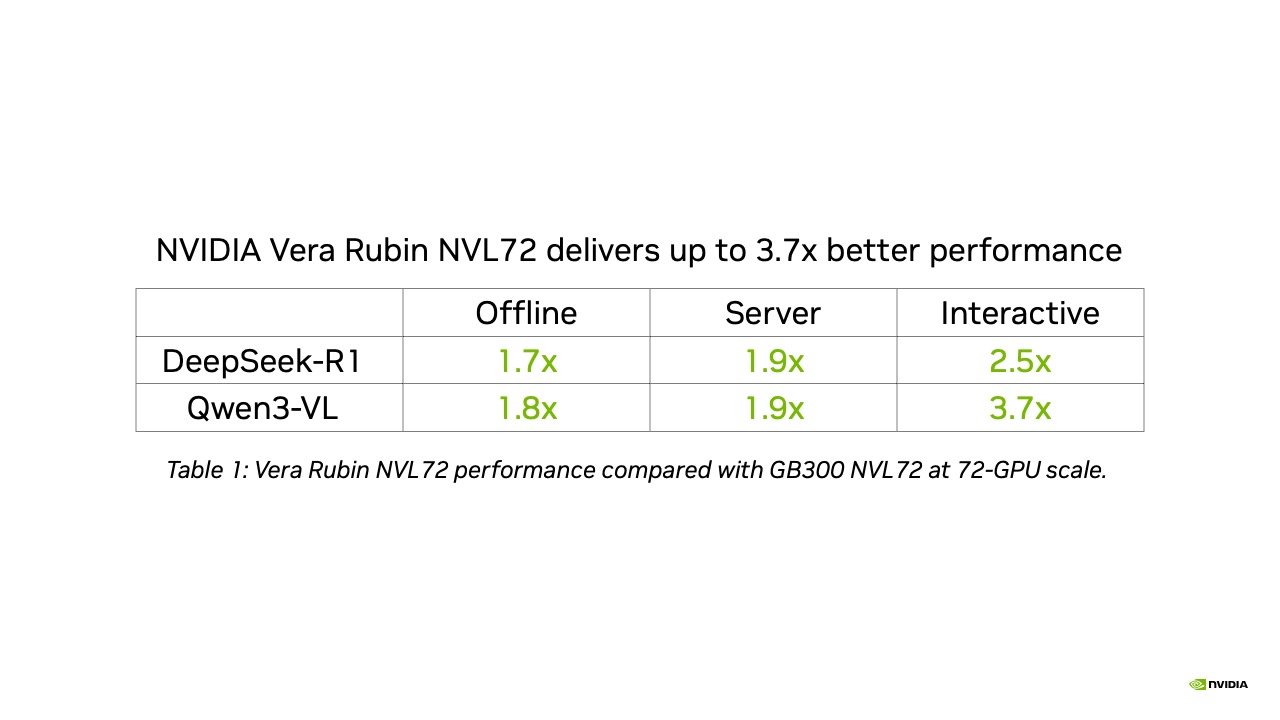
Тут також представлено перші результати NVIDIA Vera Rubin (VR200) у конфігураціях з 72 та 36 GPU. Конфігурація з 72 GPU працює до 95% швидше, ніж конфігурація GB300 з 72 GPU, тоді як конфігурація з 36 GPU випереджає конфігурацію GB200 з 72 GPU, що є вражаючим показником. Це ранній огляд, і ми побачимо ще більше результатів для Vera Rubin, коли вона буде впроваджена та протестована в наборі MLPerf.
MLPerf v6.1 DeepSeek R1
Offline (Tokens/s)
Server (Tokens/s)
| 0 | 4836599673181450977193463624182952901954 | 0 | 4836599673181450977193463624182952901954 |
| AMD MI355X (512 GPUs) | 29019502405310 | NVIDIA GB300 (288 GPUs) | 27051302028030 |
| NVIDIA GB200 (288 GPUs) | 20911901598510 | NVIDIA VR200 (72 GPUs) | 11833261175890 |
| NVIDIA GB300 (72 GPUs) | 689961603023 | NVIDIA VR200 (36 GPUs) | 558802591368 |
| NVIDIA GB200 (72 GPUs) | 542075426796 | NVIDIA GB300 (8 GPUs) | 13685480536 |
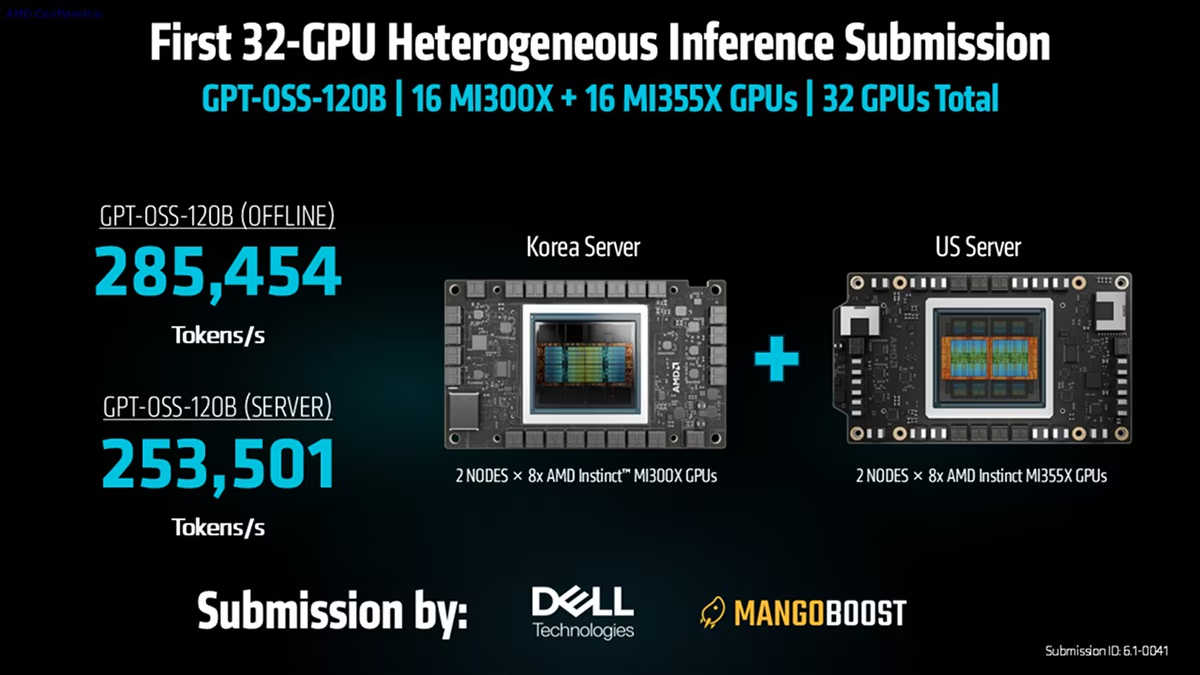
У тесті GPT-OSS 120B AMD знову продемонструвала свою найпотужнішу конфігурацію з 512 GPU, яка лідирувала як в офлайн-, так і в серверних сценаріях.
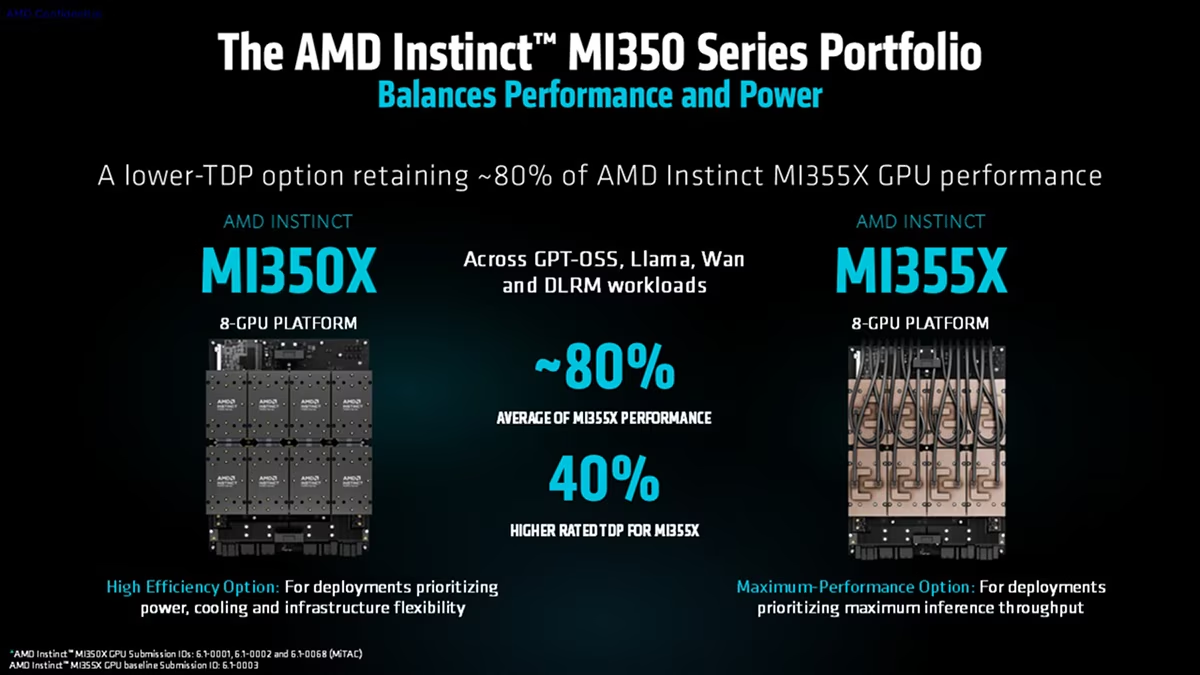
Крім того, конфігурація NVIDIA GB300 “Grace Blackwell Ultra” випередила конфігурації з 72 та 8 GPU. Рішення AMD MI350P також показало кращу продуктивність, ніж MI300X, в обох конфігураціях з 8 GPU. Intel також була представлена в тестуванні своїм продуктом Arc Pro B70, тоді як GPU NVIDIA RTX PRO також тестувалися в конфігураціях з 8 та 4 GPU.
MLPerf v6.1 GPT-OSS-120B (Max)
Offline (Tokens/s)
Server (Tokens/s)
| 0 | 95824019164802874720383296047912005749440 | 0 | 95824019164802874720383296047912005749440 |
| AMD MI355X (512 GPUs) | 57494405392930 |
MLPerf v6.1 GPT-OSS-120B
Offline (Tokens/s)
Server (Tokens/s)
| 0 | 1996193992385988577984769980951197714 | 0 | 1996193992385988577984769980951197714 |
| NVIDIA GB300 (72 GPUs) | 11977101160490 | AMD MI355X (72 GPUs) | 1039900964468 |
| NVIDIA GB200 (72 GPUs) | 911566901058 | AMD MI355X (16 GPUs) | 2284880.1 |
| NVIDIA GB300 (8 GPUs) | 132236127921 | AMD MI355X (8 GPUs) | 117804110188 |
| NVIDIA GB200 (8 GPUs) | 101453100714 | NVIDIA GB300 (4 GPUs) | 6551158195 |
| NVIDIA GB200 (4 GPUs) | 5091250613 | AMD MI350P (8 GPUs) | 4897140867 |
| AMD MI300X (8 GPUs) | 3019824863 | NVIDIA RTX PRO 6000 (8 GPUs) | 1573814784 |
| NVIDIA RTX PRO 6000 (4 GPUs) | 70816950 | Intel Arc Pro B70 (4 GPUs) | 20631351 |
У тесті Llama2 70B домінують GPU Blackwell від NVIDIA з конфігураціями на 72 GPU. NVIDIA GB300 також випередила AMD MI355X у конфігураціях з 8 GPU, але платформа Instinct виявилася швидшою за рішення GB200 Blackwell. Знову ж таки, AMD MI350P, NVIDIA RTX PRO та Intel Arc Pro показали хороші результати. Приємно бачити результати MLPerf, що подаються для платформ робочих станцій.
MLPerf v6.1 Llama2-70B
Offline (Tokens/s)
Server (Tokens/s)
| 0 | 18935037870056805075740094675011361000 | 0 | 18935037870056805075740094675011361000 |
| NVIDIA GB300 (72 GPUs) | 1136100944902 | NVIDIA GB200 (72 GPUs) | 894002910621 |
| NVIDIA GB300 (16 GPUs) | 227570179596 | NVIDIA GB300 (8 GPUs) | 132253127983 |
| AMD MI355X (8 GPUs) | 103792103932 | NVIDIA GB200 (8 GPUs) | 102703102397 |
| NVIDIA GB300 (4 GPUs) | 6600158991 | AMD MI350P (8 GPUs) | 4228641830 |
| NVIDIA RTX PRO 6000 (8 GPUs) | 3003429203 | NVIDIA RTX PRO 6000 (4 GPUs) | 1486014333 |
| NVIDIA RTX PRO 4500 (8 GPUs) | 43743012 | Intel Arc Pro B70 (4 GPUs) | 24841759 |
Нарешті, Llama 3.1-8B, де конфігурація NVIDIA GB300 (8 GPU) була до 17% швидшою за AMD MI355X (конфігурація з 8 GPU). Решту результатів можна побачити нижче:
MLPerf v6.1 Llama3.1-8B
Offline (Tokens/s)
Server (Tokens/s)
| 0 | 289925798486976115968144960173952 | 0 | 289925798486976115968144960173952 |
| NVIDIA GB300 (8 GPUs) | 171114173950 | AMD MI355X (8 GPUs) | 158458148563 |
| AMD MI350P (8 GPUs) | 7364372305 | NVIDIA RTX PRO 6000 (8 GPUs) | 5096549523 |
| NVIDIA RTX PRO 6000 (4 GPUs) | 2451124510 | NVIDIA RTX PRO 4500 (8 GPUs) | 1880018186 |
| NVIDIA RTX PRO 4500 (4 GPUs) | 95189277 | Intel Arc Pro B70 (4 GPUs) | 49774122 |
| Intel Xeon 6788P (4 Socket) | 20681030 | Xeon 6980P (2 Socket) | 19161139 |
| Xeon 6788P (2 Socket) | 1170516 |
Звичайно, ці результати чудові, але всі працюють над оптимізацією свого найновішого обладнання відповідно до майбутніх трендів ШІ. Саме тому результати, які ви бачите сьогодні, не будуть такими ж через кілька місяців. Постійна оптимізація програмного забезпечення та апаратного рівня не тільки покращує продуктивність, але й сприяє ефективності, що означає кращу пропускну здатність та більше можливостей для масштабування платформ.
Нижче наведено ключові моменти від кожної компанії щодо їхніх відповідних подань MLPerf 6.1:
- Дебют системи NVIDIA Vera Rubin NVL72 з провідною продуктивністю: У своєму першому попередньому поданні MLPerf Inference, NVIDIA Vera Rubin NVL72 забезпечує до 3.7 разів вищу пропускну здатність, ніж GB300 NVL72.
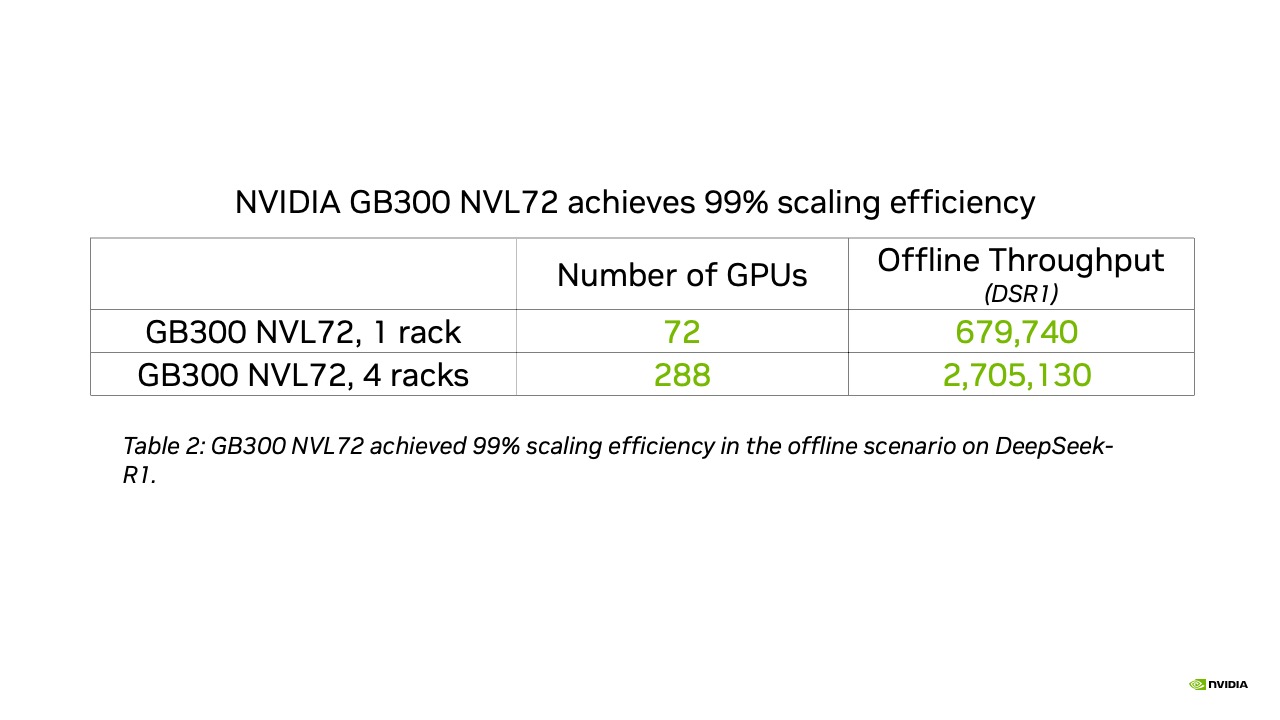
- NVIDIA GB300 NVL72 масштабується з провідною ефективністю: Подання 288 GPU в чотирьох стійках GB300 NVL72 досягло 99% ефективності масштабування, зі збільшенням пропускної здатності майже лінійно від базового рівня однієї стійки.
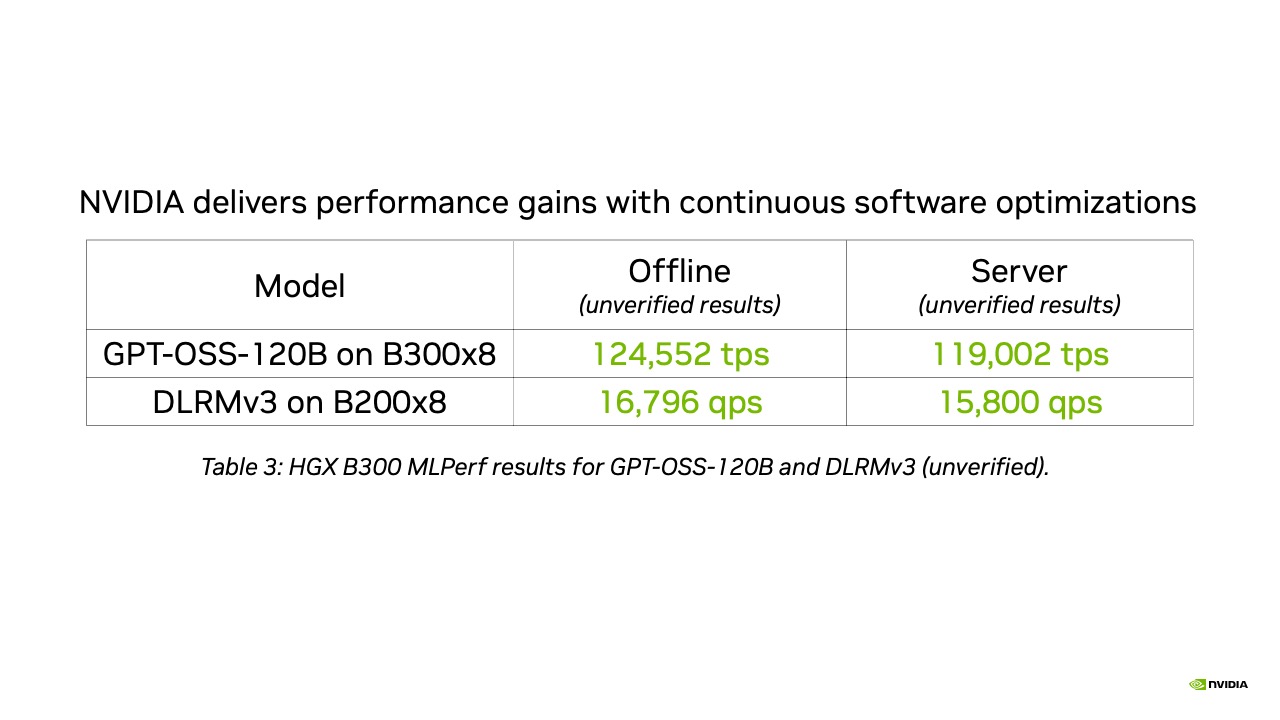
- Постійна оптимізація програмного забезпечення забезпечує зростання продуктивності: Оптимізація програмного забезпечення в поданнях NVIDIA MLPerf Inference v6.1 забезпечила до 1.6 разів вищу продуктивність порівняно з v6.0. Оптимізація тривала після подання v6.1, забезпечуючи подальше зростання продуктивності.
NVIDIA
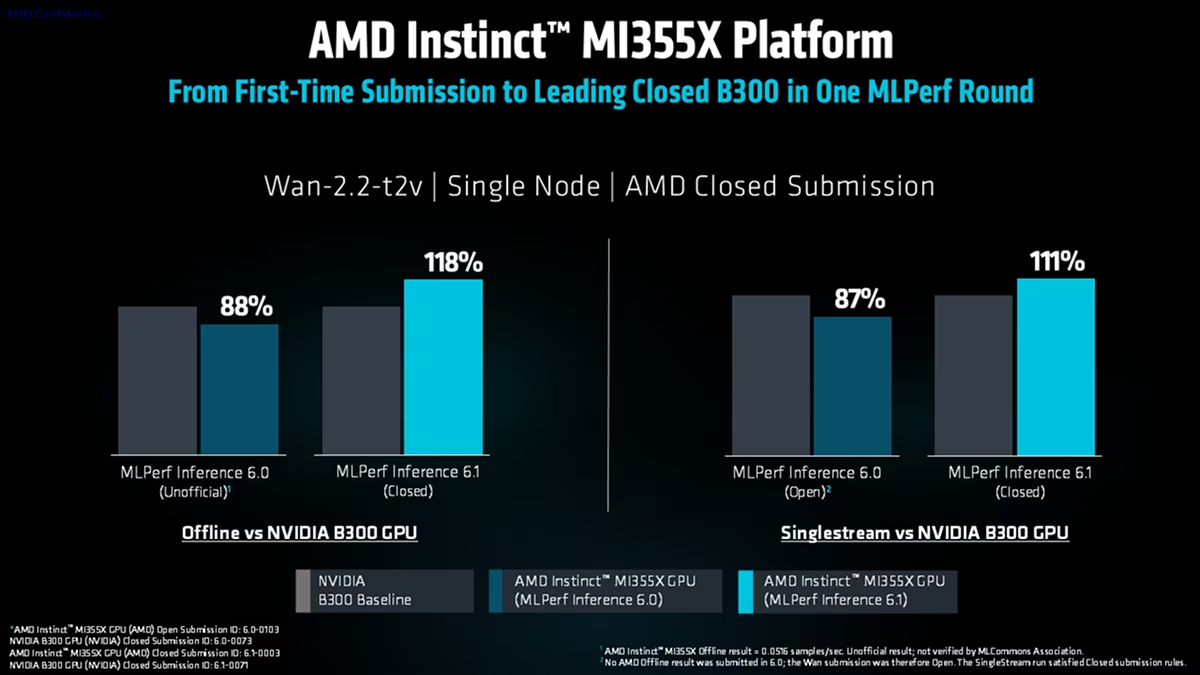
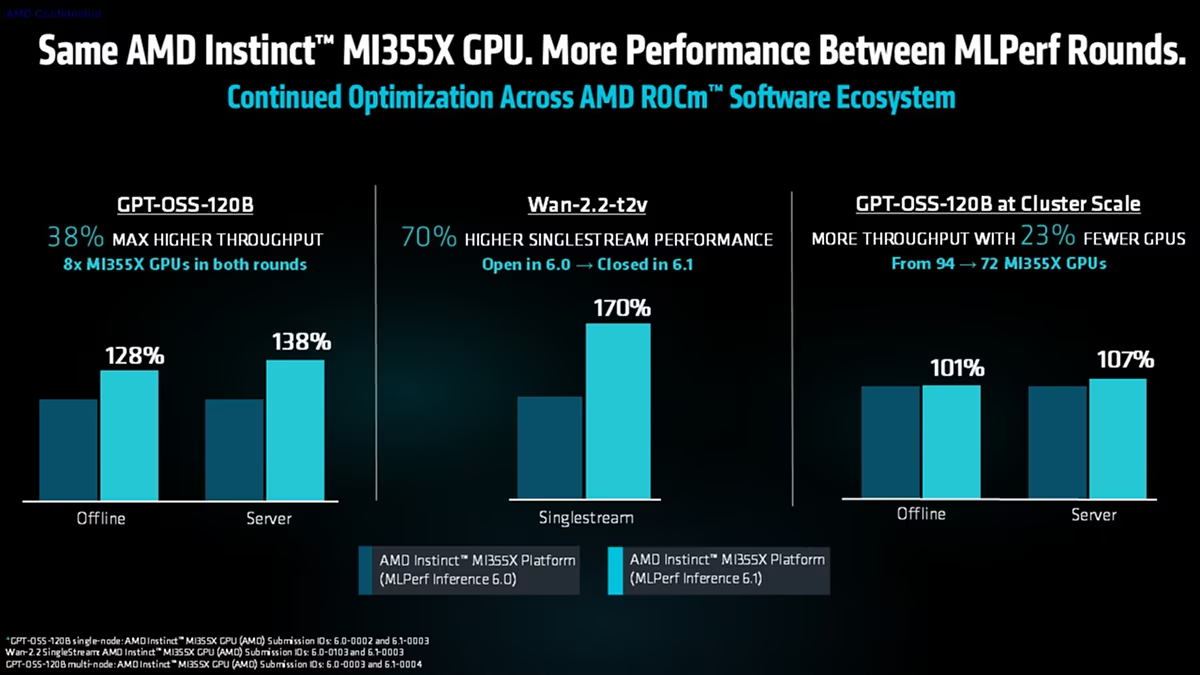
- Більша продуктивність від того самого обладнання GPU AMD Instinct MI355X: протягом одного циклу MLPerf, постійна оптимізація програмного забезпечення AMD ROCm збільшила пропускну здатність GPT-OSS-120B на 8 GPU, зменшила затримку Wan-2.2 та підвищила пропускну здатність кластера з меншою кількістю GPU.
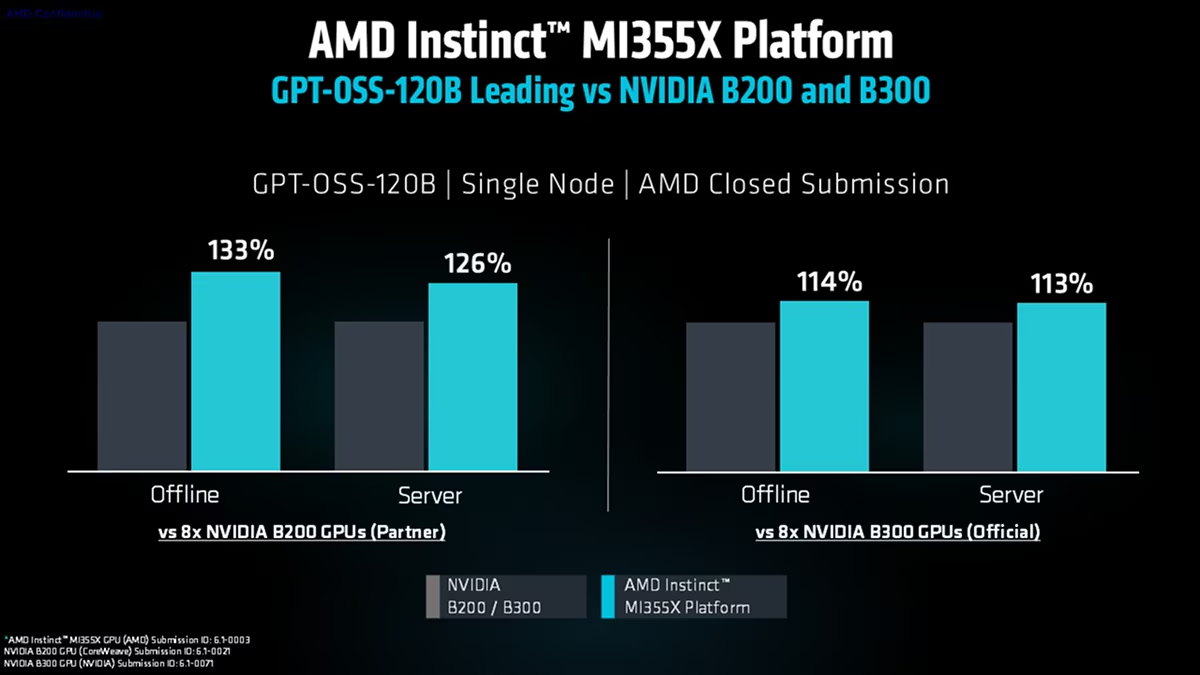
- Провідна продуктивність GPU AMD Instinct MI355X та MI350P: GPU AMD Instinct MI355X випередили результати NVIDIA B200 та B300 GPT-OSS-120B на 8 GPU та результати NVIDIA GB200 на 72 GPU. У своєму першому раунді MLPerf GPU AMD Instinct MI350P випередили вибрані результати NVIDIA RTX PRO 6000 Server Edition та H200 NVL.
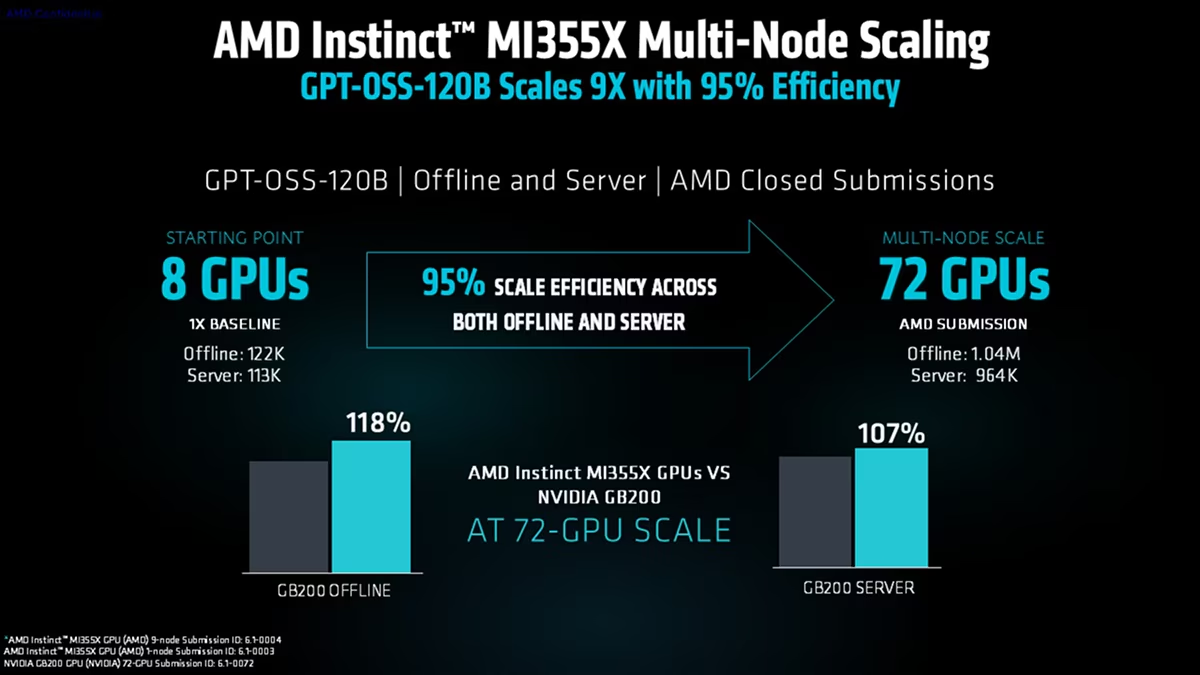
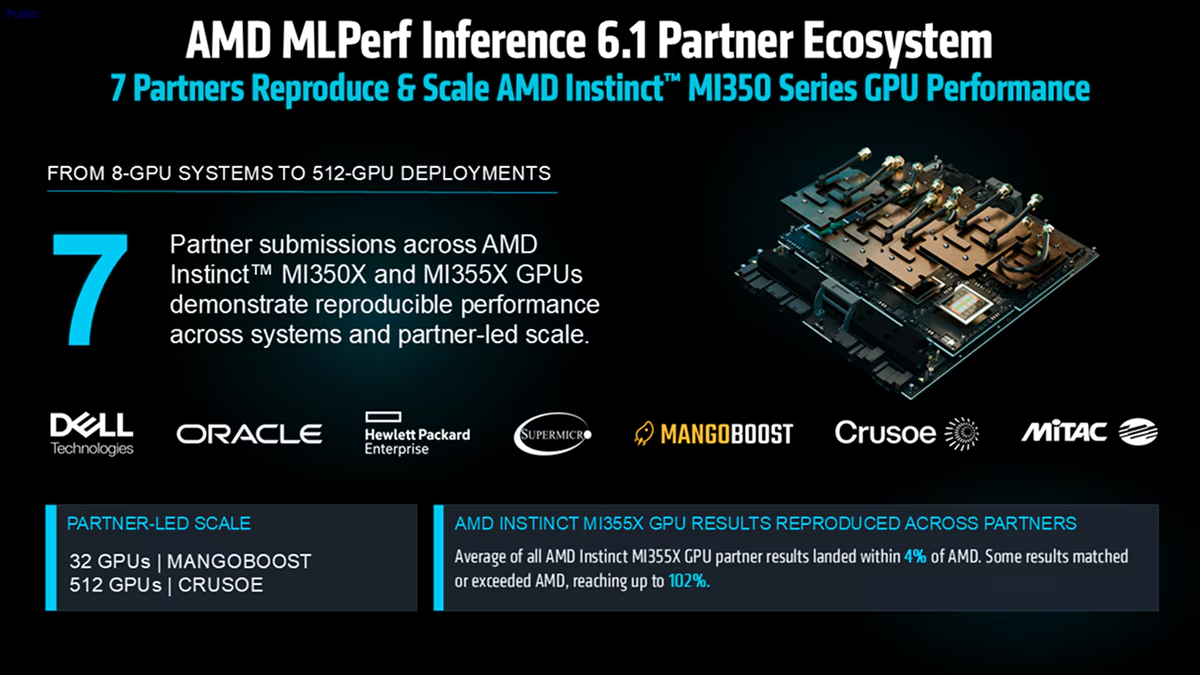
- Рекордна пропускна здатність токенів та інференс у виробничому масштабі з ефективним масштабуванням: на 72 GPU, GPU AMD Instinct MI355X досяг 95% ефективності масштабування на GPT-OSS-120B. Окремо, Crusoe досяг рекордного сукупного пропускної здатності токенів на 512 GPU, досягнувши 5.75 мільйонів офлайн-токенів за секунду на GPT-OSS-120B та 2.90 мільйонів на DeepSeek-R1.
AMD
- Про результати Intel Xeon 6: Intel розширила свою участь у Xeon у MLPerf v6.1 з двох протестованих SKU Xeon 6 у v6.0 до п’яти, збільшивши кількість результатів інференсу CPU з 24 до 35. Intel Xeon залишається єдиним окремим серверним CPU, представленим у поданнях MLPerf Inference.
- Про результати Intel Arc Pro B70: Подання Intel Arc Pro B70 демонструють, як вдосконалення програмного забезпечення можуть розширити продуктивність для низки моделей ШІ. Один вузол, сконфігурований з чотирма GPU Intel Arc Pro B70, забезпечує 128 ГБ VRAM та підтримує подання для Llama 3.1 8B, Llama 2 70B, gpt-oss-120B, Whisper та наскрізного генеративного пошуку (E2E-RAG). На тій самій системі з чотирма GPU, що використовувалася в v6.0, продуктивність gpt-oss-120B Server покращилася на 36%, а офлайн-продуктивність зросла на 27%, що відображає подальше дозрівання програмного стека Intel.
Intel
MLPerf Inference v6.1 демонструє насичене та швидкозмінне поле, а не єдиного переможця. Кластер AMD MI355X з 512 GPU встановив темп у екстремальному масштабі на DeepSeek R1 та GPT-OSS 120B, тоді як перший попередній огляд NVIDIA Vera Rubin вже виглядає як стрибок: система VR200 з 72 GPU майже подвоїла показники відповідної стійки GB300, і навіть конфігурація з 36 GPU обігнала GB200 з 72 GPU.
У більш поширених конфігураціях з 8 та 72 GPU ситуація неоднозначна — GB300 часто лідирує в Llama 2 70B та Llama 3.1 8B, AMD залишається конкурентоспроможною або випереджає в деяких тестах GPT-OSS, а MI350P, RTX PRO та Intel Arc Pro B70 доводять, що обладнання робочих станцій тепер належить до тієї ж розмови. Intel також зберегла Xeon як єдиний окремий CPU у пакеті.
Справжня історія полягає в тому, як швидко програмне забезпечення продовжує рухати показники. NVIDIA заявила про зростання до 1.6 раза завдяки роботі над стеком з моменту v6.0; AMD покращила той самий кремній MI355X протягом одного циклу; Intel підвищила результати Arc Pro на ідентичному обладнанні. Ці показники є знімками, а не стелями. Оскільки Rubin надійде в продаж, ROCm та CUDA будуть продовжувати вдосконалюватися, і з’являться нові кластери, наступний раунд MLPerf виглядатиме інакше — і це саме те, чого хоче індустрія.
Про автора: Хассан Муджтаба, інженер-програміст за освітою та ентузіаст ПК за покликанням, є старшим редактором розділу апаратного забезпечення Wccftech. Маючи багаторічний досвід у галузі, він спеціалізується на глибокому технічному аналізі процесорних та графічних архітектур нового покоління, материнських плат та систем охолодження. Його робота включає не тільки оперативні новини про майбутні технології, але й всебічні огляди та бенчмаркінг.
Пропозиція дня
Додатково для читання
Intel Arc Pro B70 перевершує NVIDIA RTX 5090D в DeepSeek R1 AI LLM, коштуючи чверть ціни, пропонуючи понад 2000 токенів/сек
Хассан Муджтаба
Maxsun Intel Arc Pro B70 32G Graphics Card Hands On Impressions: Big Battlemage Stuns With Big Uplifts Over B580
Хассан Муджтаба
Intel Arc Pro B70 перевершує NVIDIA RTX Pro 4000 в AI за половину ціни, на 33% більше пам’яті
Хассан Муджтаба
Tenstorrent TT-QuietBox 2 запущено: AI-робоча станція на базі RISC-V з 128 ГБ пам’яті GDDR6, рідинним охолодженням та стартовою ціною $9999
Хассан Муджтаба
Оригінал статті: wccftech.com