
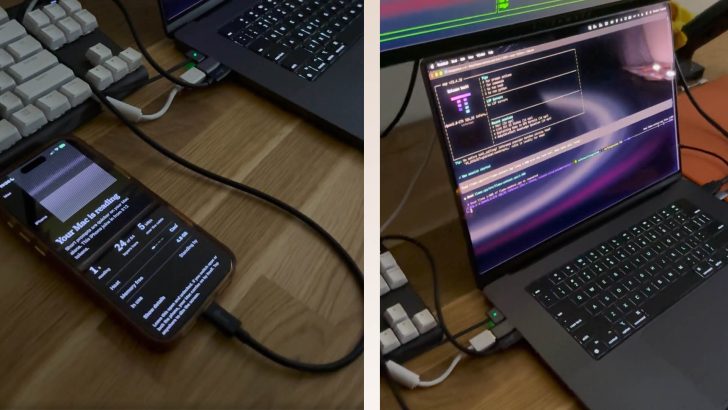
Qwen3.8-27B — це потужна модель ШІ, яка вимагає достатнього обсягу VRAM та системної оперативної пам’яті. На MacBook Pro з чипом M4 Pro 24 ГБ уніфікованої пам’яті можуть обмежувати швидкість префілтингу під час роботи моделі ШІ. На щастя, один користувач підключив iPhone 17 Pro Max до портативного Mac через порт USB-C та, запустивши спеціалізоване програмне забезпечення, досяг збільшення швидкості префілтингу на 44% при роботі тієї ж моделі ШІ.
Навіть зі збільшенням обсягу пам’яті до 20 480 МБ, M4 Pro MacBook Pro обмежений вікном контексту 64K, що робить iPhone 17 Pro Max необхідним
Щоб обійти обмеження Mac у 24 ГБ уніфікованої пам’яті, користувач Reddit “u/StayLameBro” розподіляє навантаження між комп’ютером та iPhone 17 Pro Max двома способами. Для прискорення префілтингу MacBook Pro обробляє шари з 1 по 40 кожної партії з 256 токенів і передає активації на телефон. iPhone ж обробляє шари з 41 по 64 на GPU свого чіпа A19 Pro, тоді як Mac розпочинає наступну партію. Використання GPU робить роботу телефону приблизно в 2,4 рази швидшою, ніж без них.
Neural Engine також не залишається без роботи: кожні 16K старого контексту компілюються в модель Neural Engine, що скорочує час запису на токен при контексті 140k з 279 мс до 176 мс порівняно з роботою лише GPU A19 Pro. Щодо продуктивності при префілтингу файлу обсягом 2000 токенів у збережену сесію: при контексті 8K Mac самостійно досягав 132 токенів/секунду проти 177 токенів/секунду з iPhone, що становить 35% приросту. При 16K цей показник зріс зі 109 токенів/секунду до 157 токенів/секунду, що призвело до вражаючого збільшення на 44%.
Я зробив зі свого iPhone другий GPU для мого MacBook з 24 ГБ: Qwen 3.8 27B прискорює префілтинг на 29–44% та частково утримує вікно CTX.
від u/StayLameBro у LocalLLaMA
При вікні контексту 32K швидкість префілтингу зросла зі 101 токен/секунду до 130 токен/секунду, забезпечивши покращення на 29%. Підключивши iPhone 17 Pro Max до M4 Pro MacBook Pro, можна було б очікувати неймовірної швидкості префілтингу завдяки спеціалізованому програмному забезпеченню. На жаль, це сценарій “надто добре, щоб бути правдою”, оскільки користувач Reddit висвітлює кілька обмежень. Наприклад, телефон не прискорює генерацію тексту при контексті нижче 64K, що залишається завданням для Mac.
Також варто зазначити, що A20 Pro, який живить iPhone 18 Pro та iPhone 18 Pro Max, може запропонувати більший запас продуктивності не лише завдяки вищій швидкості, але й завдяки своєму двоядерному Neural Engine з 16 ядрами, який, як стверджується, забезпечує вищу пропускну здатність, ніж 7-ядерний GPU SoC, для завдань, спеціально оптимізованих для NPU. Спеціалізоване програмне забезпечення наразі є відкритим і може бути завантажене з GitHub під назвою “backburner”.
Навіть як експеримент, вже видно, що збільшена швидкість префілтингу дає суттєвий приріст. Звісно, його можливості можна досліджувати далі, хоча це також може означати, що такі пристрої, як iPhone, можуть увійти в еру дефіциту, подібну до тієї, що спостерігається з DRAM та SSD.
За даними порталу: wccftech.com