
NVIDIA представила оптимізацію енергоефективності своїх платформ Vera Rubin для збільшення пропускної здатності токенів.
NVIDIA оголошує про значні переваги в енергоефективності своїх платформ Vera Rubin на AI Infra Summit
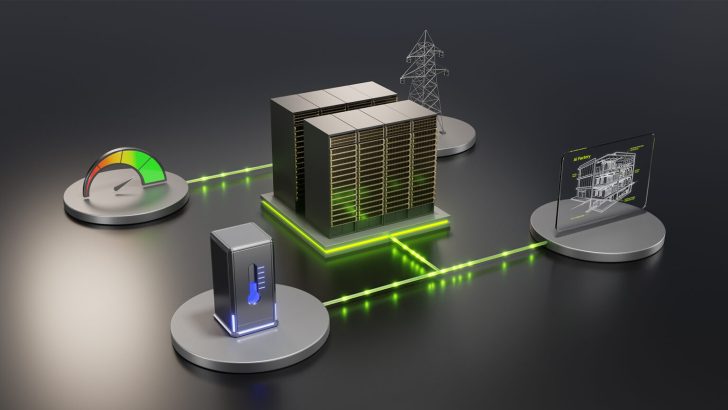
Зростаючий попит на ШІ створює серйозне навантаження на енергетичну інфраструктуру. Для вирішення цієї проблеми NVIDIA розробляє широкий спектр рішень у рамках своєї повноцінної платформи AI Factory. Вона охоплює системи Vera Rubin, програмне забезпечення для інференсу Dynamo, бібліотеки NeMo та різноманітні мережеві рішення, включаючи NVLink для масштабованих обчислень, Spectrum-X для Ethernet та SuperNIC ConnectX для підключення тисяч вузлів, сховище контекстної пам’яті на базі BlueField та DPUs BlueField для безпеки інфраструктури.
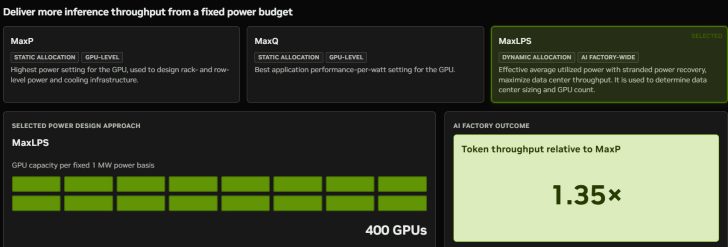
Щоб забезпечити максимально можливу пропускну здатність токенів фабрик ШІ, рішення NVIDIA DSX MaxLPS підвищує пропускну здатність токенів до 40% на мегават. DSX вже використовується Emerald AI у їхній платформі Conductor, що є прикладом координації роботи з енергомережею, яку пропонує DSX.
Завдяки DSX Flex платформа Conductor AI динамічно регулює потреби дата-центру в електроенергії залежно від умов енергомережі. Мета платформи — зменшити споживання електроенергії в періоди пікового навантаження на мережу, забезпечуючи безперебійну роботу критично важливих ШІ-навантажень.
Наразі платформа отримала 200 сигналів щодо стану енергомережі та щоразу працювала бездоганно, без втручання користувача. Крім того, хмарні провайдери, такі як Lambda, вже протестували платформу і досягли на 24% вищої пропускної здатності токенів при фіксованому бюджеті потужності.
Lambda, провайдер хмарних послуг GPU, який обслуговує понад 10 000 клієнтів від стартапів, що працюють на основі ШІ, до гіперскейлерів, запустив програмне забезпечення на кластері з п’яти стійок та 19 вузлів.
Результати: працюючи з 19 вузлами в межах того ж бюджету потужності, що й 16 вузлів при повній потужності, Lambda досягла на 24% більшої сукупної пропускної здатності токенів — приблизно з 4 мільйонів токенів на секунду до 5 мільйонів. Продуктивність на ват покращилася на 23%.
Ці переваги призводять до збільшення пропускної здатності токенів у стійках Vera Rubin та Groq 3 LPX:
- До 40% більше GPU в межах того ж енергетичного бюджету
- До 35% вища пропускна здатність токенів — нові лінії електропередач не потрібні
Цифри говорять самі за себе. При навантаженні Qwen 3.8 27B зі 100K-контекстом Groq 3 LPX досягав 2529 вихідних токенів на секунду на користувача. Цей запас потужності дозволяє агентам виконувати більше кроків міркування та викликів інструментів у межах того ж бюджету відповіді, навіть при масштабуванні навантажень.
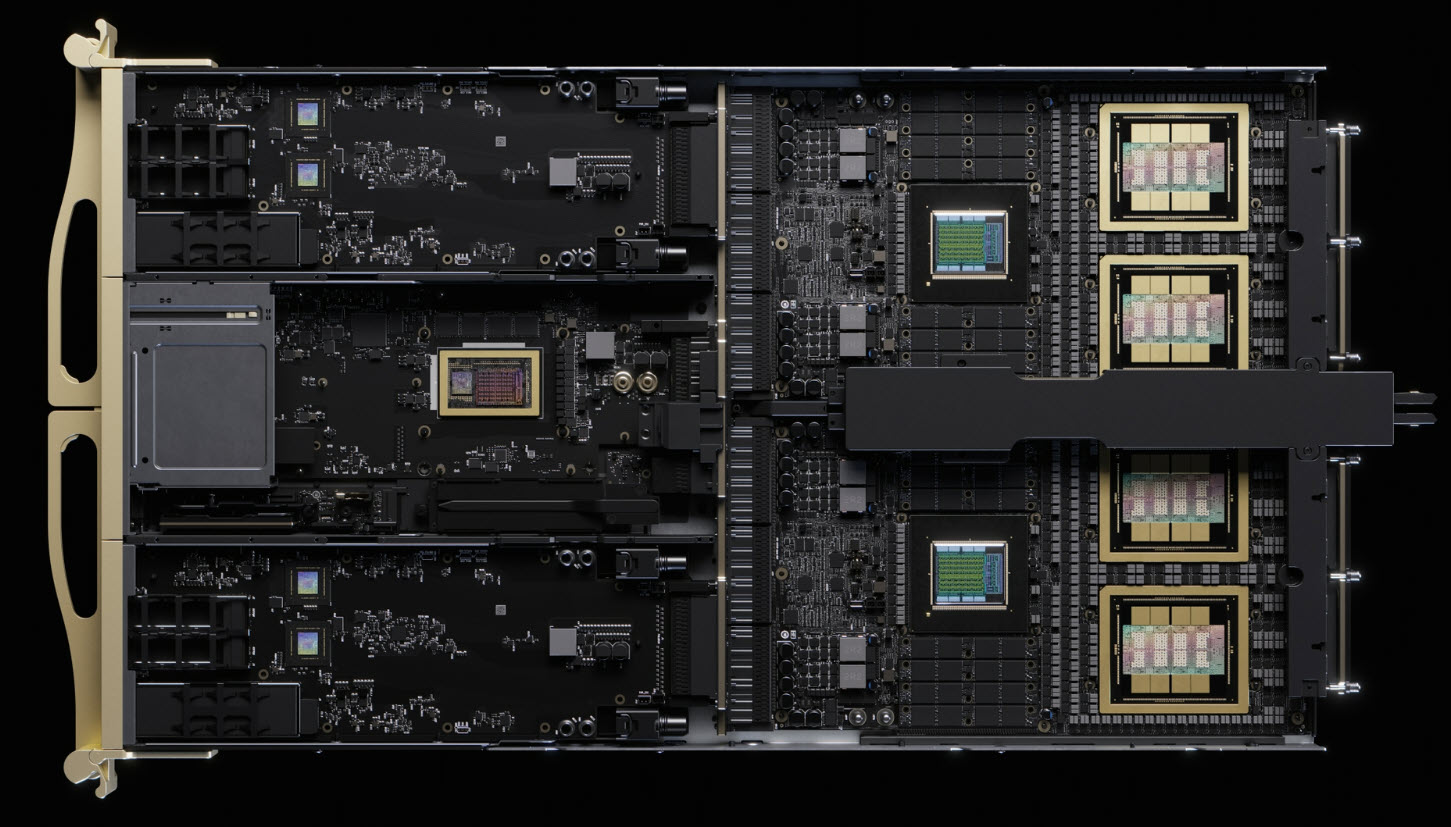
Стартапи по всьому світу також діляться своїми враженнями від центральних процесорів NVIDIA Vera. Ранні результати від різних компаній, що займаються ШІ, показують до 1,9-кратного зростання, значно нижчі затримки, на 73% вищу пропускну здатність та 3,3-кратне збільшення пропускної здатності в завданнях запитів порівняно з іншими процесорами.
Perplexity протестував CPU Vera для своєї нової платформи безпечних пісочниць SPACE для агентного ШІ, продемонструвавши прискорення запуску пісочниць у 1,9 рази.
Daytona протестував CPU Vera на агентних навантаженнях, відзначивши «серйозні переваги для агентного виконання».
ClickHouse поділився результатами тестування Vera CPU на ClickBench, своєму відкритому бенчмарку для аналітичних баз даних. Vera виявився найшвидшою машиною, яку виміряла команда на сьогодні. Це «сильний сигнал того, що чекає на продуктивність CPU для навантажень, інтенсивних до даних», — зазначили в ClickHouse.
DeepInfra провела низку бенчмарків на CPU Vera, показавши його перемогу за всіма показниками, включаючи прискорення оркестрації у 2,2 рази.
Prime Intellect виявив, що CPU Vera підтримував високу пропускну здатність та низькі, стабільні затримки пам’яті при паралельному виконанні більшої кількості навантажень — саме той передбачуваний рівень продуктивності, який необхідний для агентного ШІ.
Redpanda повідомила, що їхній бенчмарк CPU Vera показав у 5,5 рази нижчі затримки та на 73% вищу пропускну здатність порівняно з іншими CPU.
Starburst опублікував результати бенчмарків, які показали, що CPU Vera забезпечив у 3 рази швидшу пропускну здатність запитів порівняно з іншими CPU.
Kinetica відзначила у 2,7 рази швидшу продуктивність аналітичних запитів з CPU Vera порівняно з традиційними CPU. 22
NVIDIA та її партнери перетворюють дата-центри на спеціально розроблені фабрики ШІ, які вимірюються не за піковими FLOPS, а за підтвердженими токенами на мегават. Від роботи Annapurna з NVHBM та інтеграцій NVLink Fusion від d-Matrix до програми гнучкого керування навантаженням Emerald AI від Silicon Valley Power, 23% приросту продуктивності на ват від Lambda з DSX MaxLPS, візуального ШІ Blackwell-plus-Dynamo від Pinterest, 30-кратного збільшення пропускної здатності AgentX від Vera Rubin NVL72 та екстремальної переваги в затримках Groq 3 LPX, а також низки перемог CPU Vera та масштабованої стійкості NVLink 6.
Основний меседж був незмінним: повноцінні системи від кремнію до програмного забезпечення та енергомережі можуть видобувати більше токенів, захищати пріоритетні навантаження та максимально ефективно використовувати кожен мегават, перетворюючи обмежену потужність на вищу пропускну здатність, нижчу вартість за токен та більшу економічну цінність для наступного покоління інфраструктури ШІ.
Про автора: Хасан Муджтаба, інженер-програміст за освітою та ентузіаст ПК за покликанням, є старшим редактором розділу обладнання Wccftech. Маючи багаторічний досвід роботи в галузі, він спеціалізується на глибокому технічному аналізі архітектур процесорів та відеокарт наступного покоління, материнських плат та систем охолодження. Його робота включає не лише висвітлення новин про майбутні технології, але й розширені практичні огляди та бенчмаркінг.
Слідкуйте за Wccftech у Google, щоб отримувати більше наших новин у своїх стрічках.
Пропозиція дня
Подальше читання
Cerebras CS-4 генерує за 1 секунду те, що для стійки GPU займає 30 секунд, використовуючи WSE-3 Turbo з 4 трильйонами транзисторів
Центральний процесор NVIDIA Vera випереджає традиційні чіпи x86 завдяки дизайну, орієнтованому на агентний ШІ, забезпечуючи в 6 разів вищу продуктивність та на 40% нижчу затримку
Центральний процесор NVIDIA Vera залучає CoreWeave, Meta, Oracle та Alibaba як ранніх покупців, відкриваючи багатомільярдний фронт за межами стійок Rubin
AMD нарешті випереджає Intel за доходами від дата-центрів у 1 кварталі, оскільки агентний ШІ змушує гіперскейлерів скуповувати CPU замість GPU
Подробиці можна знайти на сайті: wccftech.com